LydStone Lab — 97,4 % успеха и вердикт «не прошёл»
Задача
Компании внедряют искусственный интеллект, не имея способа заранее узнать, справится ли он.
Решение обычно принимают по демонстрации и общему впечатлению: модель отвечает бегло, ответы выглядят разумно — значит, подходит. Но правдоподобный ответ и правильный ответ — разные вещи, и разница обнаруживается уже в работе, когда цена ошибки ложится на процесс и на людей.
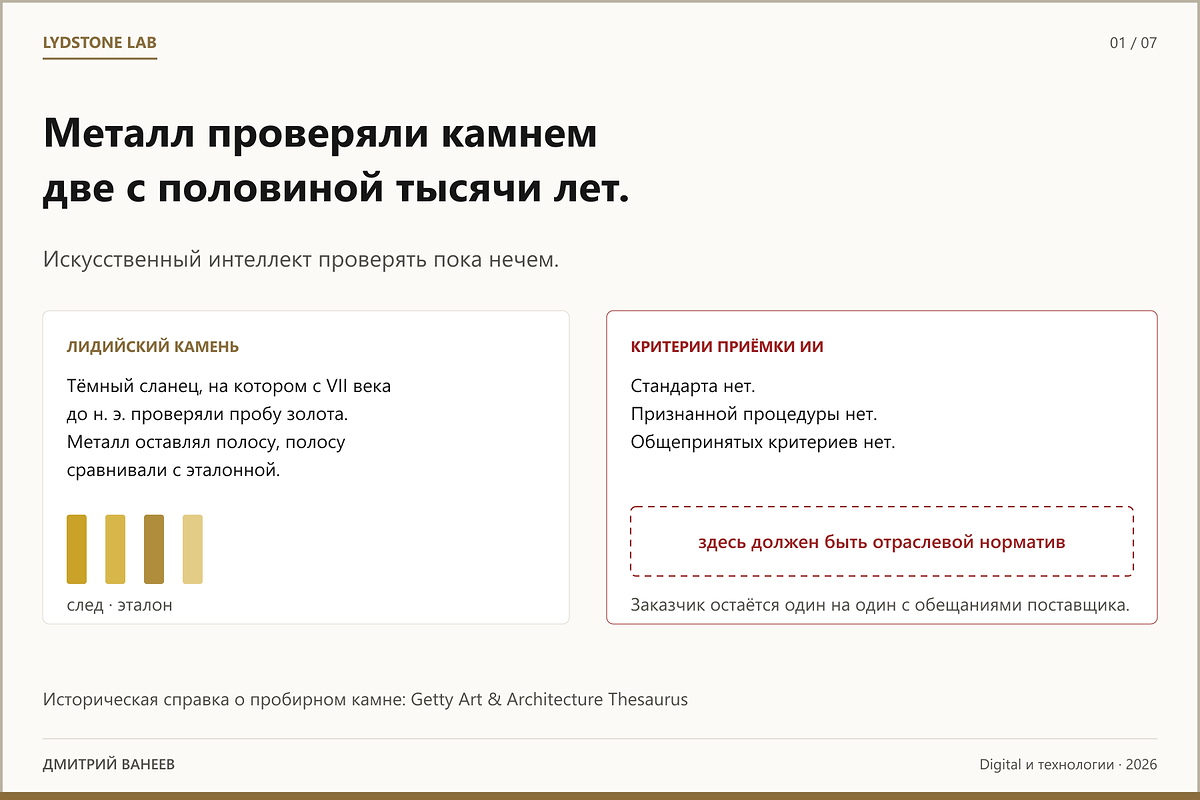
Отраслевого норматива, с которым можно сверить пригодность конкретной конфигурации ИИ для конкретной задачи, сегодня не существует. Нет ни стандарта, ни признанной процедуры, ни общепринятых критериев приёмки. Заказчик остаётся один на один с обещаниями поставщика.
Я поставил задачу так: сделать выбор ИИ проверяемым инженерным решением, а не вопросом доверия. Для этого нужно ответить на три вопроса. Какие задачи можно доверить конкретной конфигурации? Где проходит граница её достаточности? Какой ценой — по времени, памяти и объёму вывода — достигается результат?
Отдельное требование я предъявил к самому методу: он должен уметь выдавать отрицательный вывод. Исследование, которое всегда находит победителя, бесполезно. Поэтому «ни один из проверенных вариантов не подходит» — законный результат, а не признак неудачной работы.
Решение
Я создал LydStone Lab — лабораторию прикладных исследований ИИ — и её измерительное ядро CogniScope.
Название отсылает к лидийскому камню: пробирному камню, на котором две с половиной тысячи лет проверяли, соответствует ли металл заявленной пробе. Задача лаборатории та же — сопоставить заявленное свойство с наблюдаемым результатом.
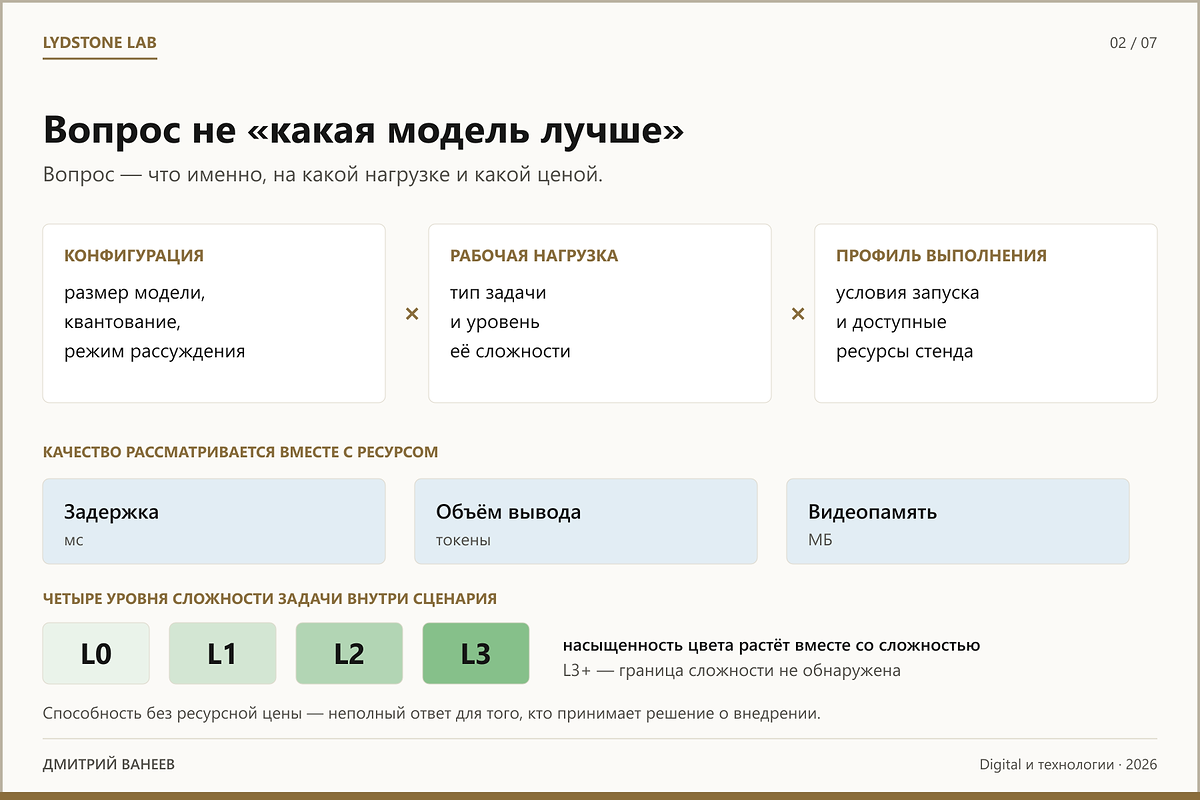
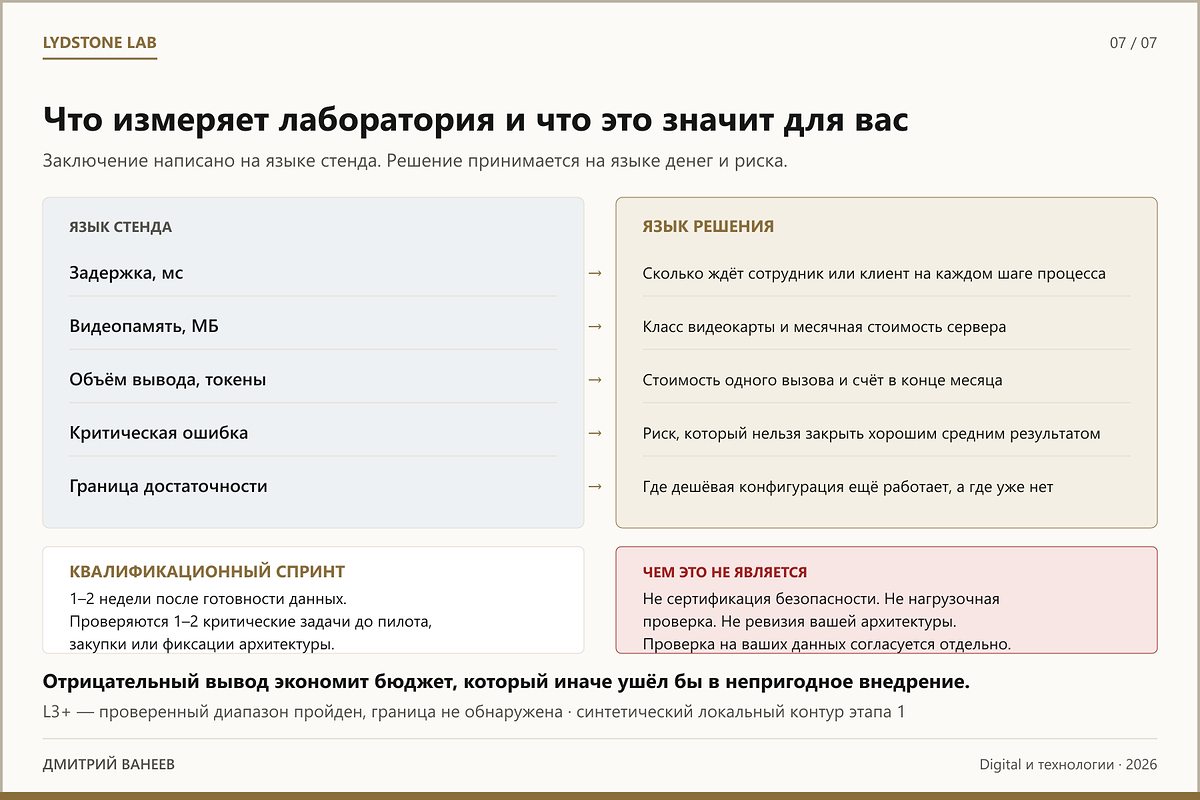
Единица проверки. Я отказался от привычного «модель X лучше модели Y». Проверяется сочетание «конфигурация × рабочая нагрузка × профиль выполнения», и качество рассматривается вместе с задержкой, видеопамятью и объёмом ответа. Способность без ресурсной цены — неполный ответ для того, кто принимает решение о внедрении.
Сценарии. Первый этап охватил семь групп задач, в которых правдоподобный ответ особенно легко скрывает ошибку: уточнение недостающих данных, извлечение фактов из документов, распознавание противоречий между источниками, вывод по цепочке правил, диагностика причин, приоритизация сигналов, подготовка текста с обязательными и запрещёнными условиями.
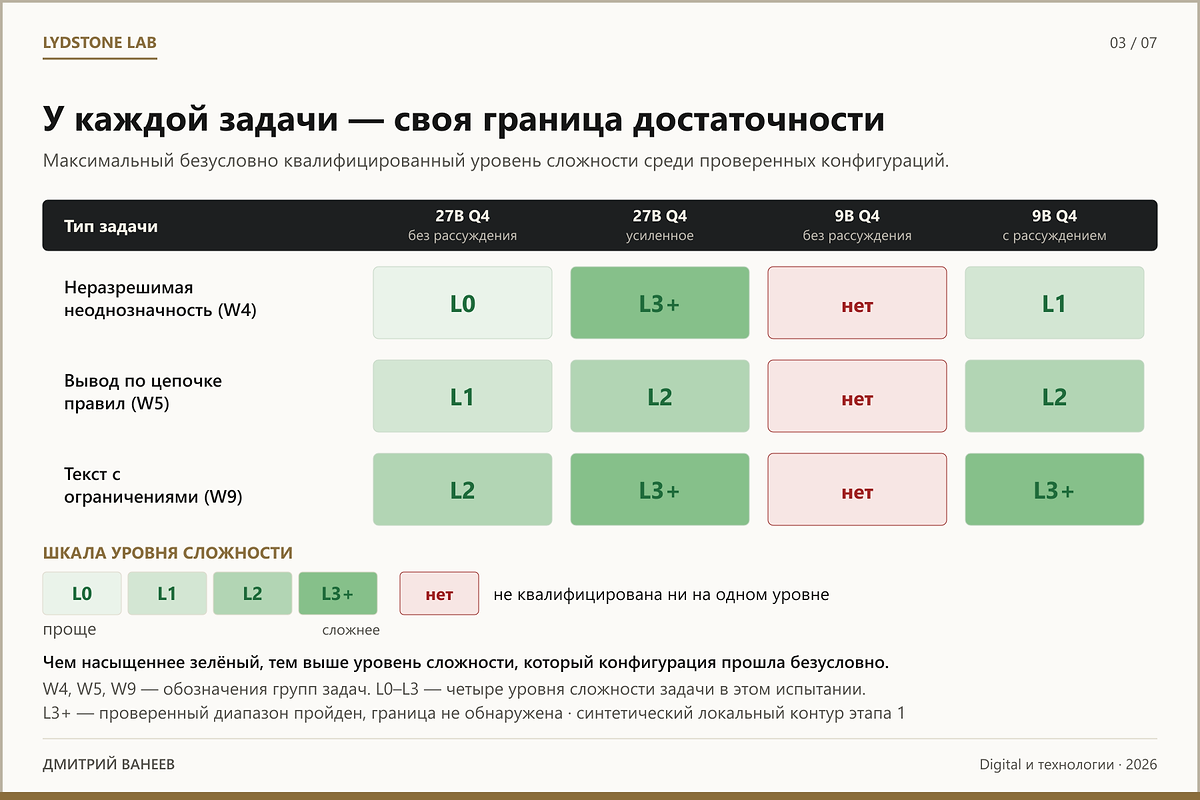
Уровни сложности. Внутри каждого сценария задан диапазон L0–L3, в котором ищется граница достаточности. L3+ означает, что весь проверенный диапазон пройден и граница в нём не обнаружена, — и ничего не обещает за его пределами.
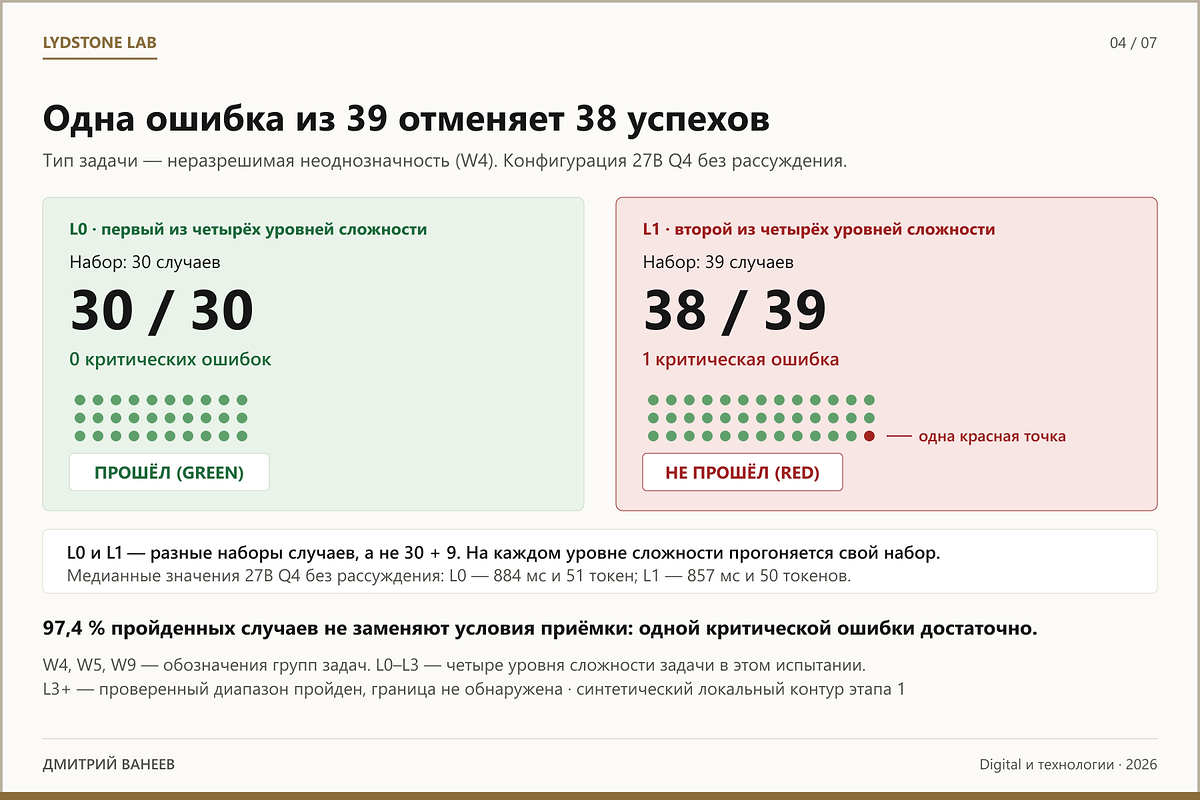
Правило приёмки. Критические ошибки имеют нулевой допуск. Доля пройденных случаев не заменяет условия приёмки: недопустимую для процесса ошибку нельзя компенсировать хорошим средним результатом.
Проверка самого метода. Методологию разбирали несколько языковых моделей разных поставщиков, независимо друг от друга; замечания разобраны, часть метода доработана, разбор повторён. Я называю это перекрёстной машинной рецензией, а не независимым аудитом: у рецензента нет профессиональной ответственности за заключение, а модели могут разделять слепые зоны — в том числе с теми, которые лаборатория исследует. Применять к собственному методу более мягкий критерий, чем к предмету исследования, я не могу.
Результат
Первый этап программы завершён. Три результата показывают, зачем нужна такая проверка.
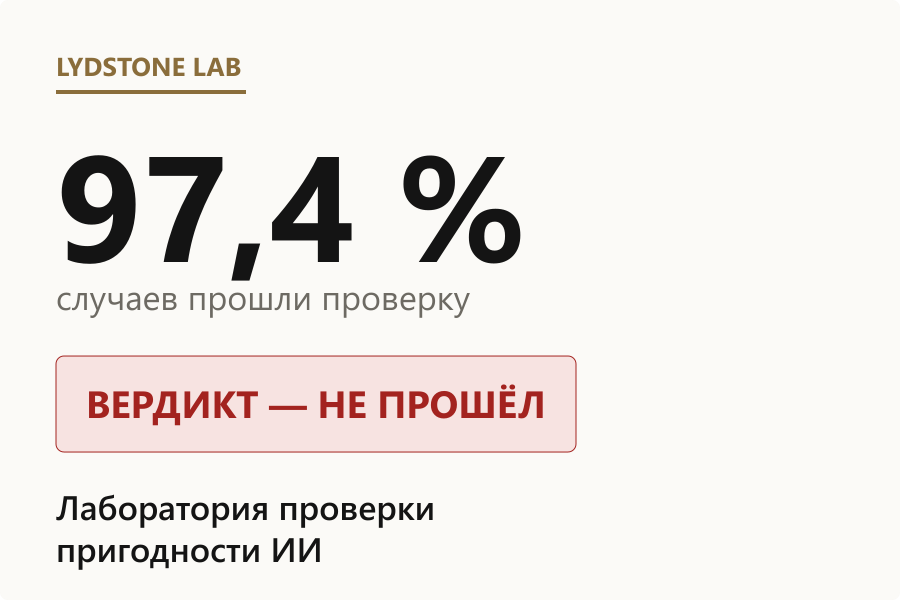
97,4 % — и вердикт «не прошёл». В задаче распознавания неразрешимой неоднозначности конфигурация 27B Q4 без рассуждения прошла уровень L0 без единой критической ошибки: 30 из 30 случаев, медианная задержка 884 мс. На следующем уровне прошли 38 случаев из 39. Одна ошибка нарушила правило нулевого допуска — вердикт RED, «не прошёл». Если бы решение принимали по доле успеха, эта конфигурация ушла бы в работу.
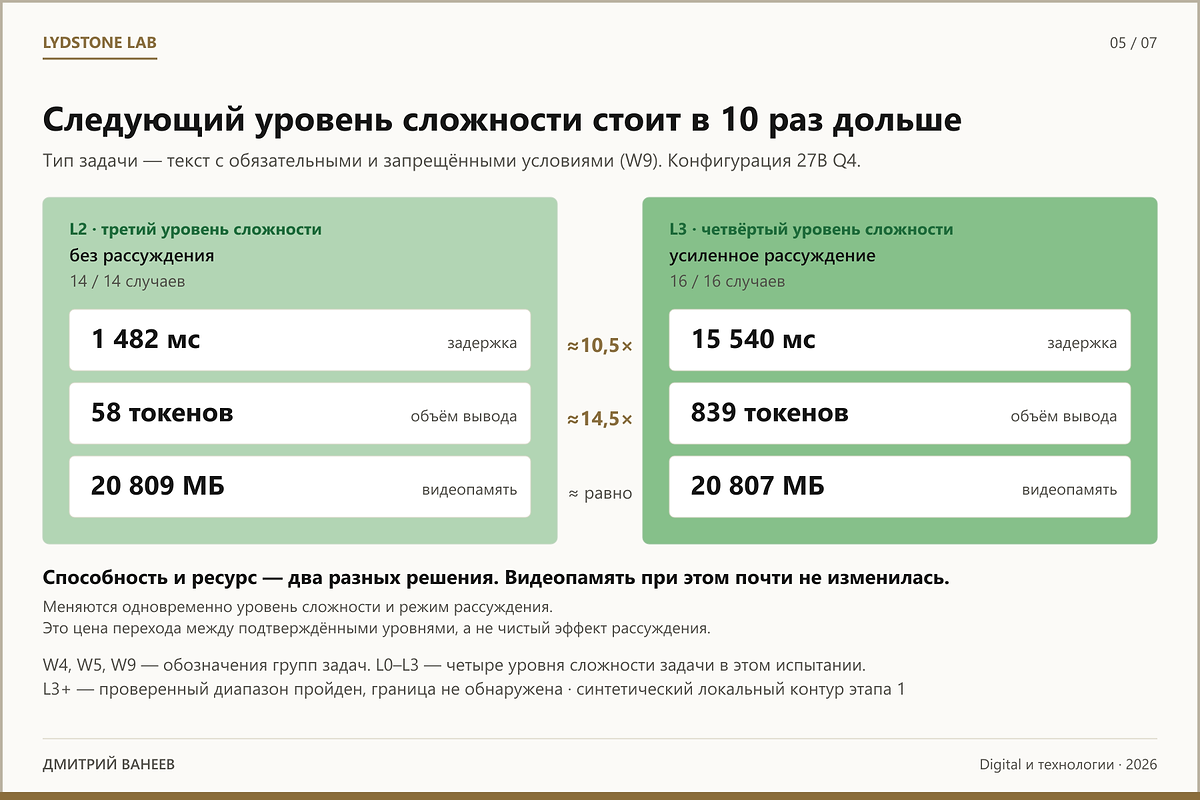
Следующий уровень способности имеет цену. В задаче с обязательными и запрещёнными условиями та же конфигурация без рассуждения прошла L2, а с усиленным рассуждением — L3. Переход между подтверждёнными уровнями стоил примерно десятикратного роста задержки и четырнадцатикратного роста объёма вывода при практически неизменной видеопамяти. Способность и ресурс — не одно решение, а два.
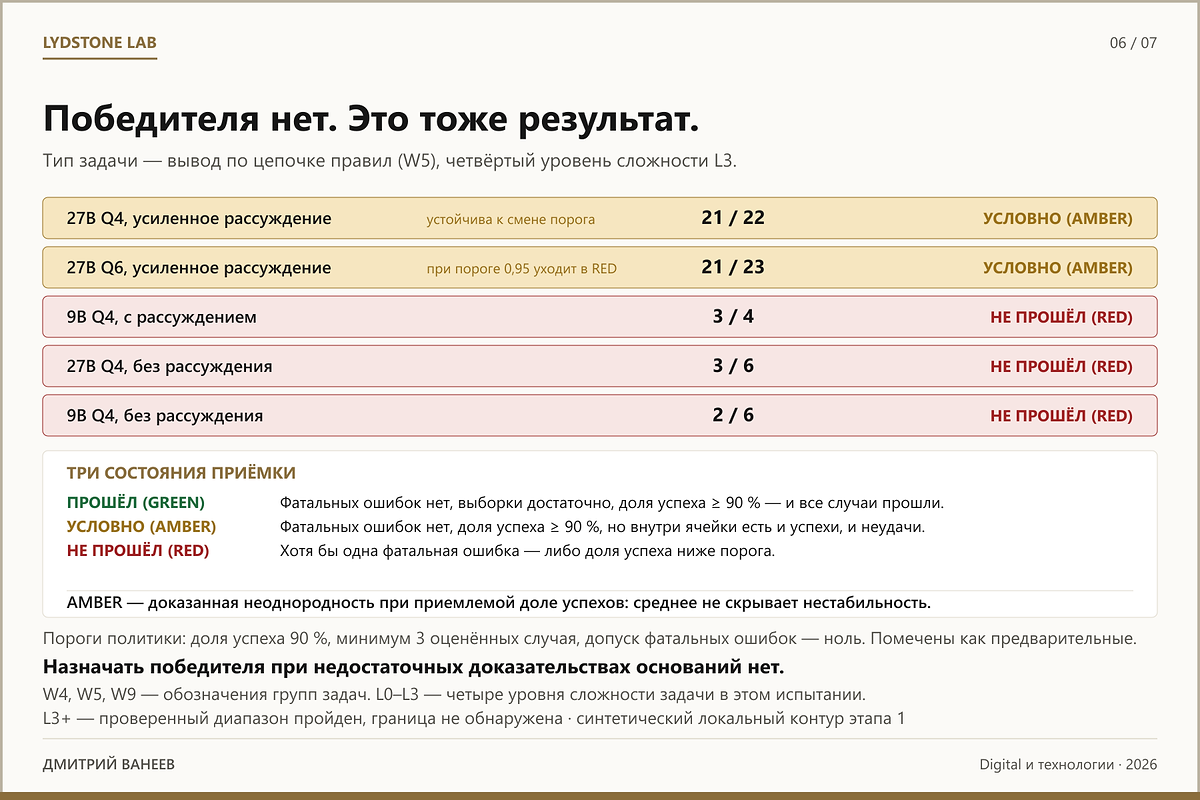
Обоснованный отказ — тоже результат. В задаче вывода по цепочке правил ни одна проверенная конфигурация не получила на L3 безусловного «прошёл». Две получили условный статус, три — отрицательный. Заключение сохранено в этом виде: назначать победителя при недостаточных доказательствах оснований нет.
Это правило переносится далеко за пределы ИИ. Спросите у подрядчика не долю успеха, а какую ошибку он считает недопустимой и что произойдёт, если она случится один раз из сорока. Ответ на этот вопрос говорит о готовности решения больше, чем любой процент в презентации.
Отрицательные и неразличающие результаты не удалены. Два сценария из семи не дали надёжного различения конфигураций — они сохранены и прямо исключены из оснований для выбора. Доказательная база закреплена: cogniscope-stage1b-final, коммит 0dac1339.
Границы. Первый этап проведён на синтетических задачах в локальной среде, на одном хосте, с пилотной статистикой. Он не подтверждает промышленную безопасность, работу под нагрузкой, экономику облачного исполнения и не заменяет проверку на реальных данных заказчика. Процедура поиска границы требует дальнейшей валидации. Я перечисляю это здесь, а не примечанием мелким шрифтом, потому что заключение без границ применимости не является заключением.
Презентация проекта